
上个月一个做物联网项目的客户找到我,说他们的 MongoDB 数据库每天凌晨都会抖一下,报警短信一天来三四条。我第一反应是他们监控阈值设太松了,让他们把告警改严一点。结果客户把日志贴过来一看,根本不是慢,是每到凌晨就有一次主节点切换,连接被断掉,应用层疯狂重连。我让他去做一次断电演练,结果这一测就测出了 12 秒的空窗从主节点彻底断电到有人接上主,读写完全恢复,正好 12 秒多。这事后来我复盘了好几遍,也顺手把 MongoDB 副本集这套选举机制捋清楚了,今天就写下来,省得下一个人再花两晚上排查。
如果你正在给业务搭一套 MongoDB 高可用、或者手里已经有一个副本集但心里没底它到底靠不靠谱,可以先看看这两家的机器做个对比:RackNerd(全球VPS,特价常推)、狗云DOGYUN(高性价比云服务器,多机房可选),做副本集最少要三台机器,同一内网低延迟部署效果最稳,配置按 2 核 4G 起步就够跑中小规模业务了。
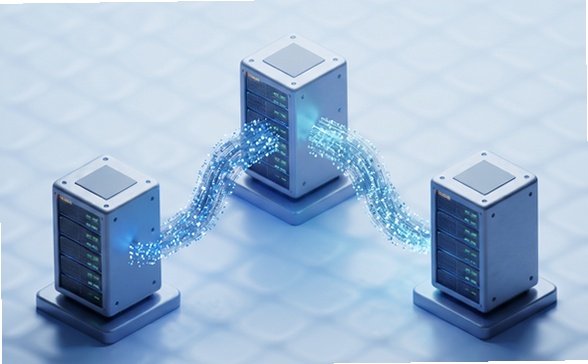
先说人话版。MongoDB 的副本集(Replica Set),就是一台主节点(Primary)负责所有写操作,再配两台从节点(Secondary)跟着它同步数据。客户端连主节点读写,MongoDB 自己会保证主节点掉线时,从节点里有人顶上来接任。
关键在「保证」这两个字是怎么做到的。MongoDB 内部靠两个机制:一个是 oplog,主节点把每一次写操作都追加到 oplog 里;从节点不断拉取主节点的 oplog 并回放,从而保持数据一致。另一个是心跳,每个节点之间每两秒互相发一次心跳包,告诉对方「我还活着」。如果某个节点连续 10 秒收不到其他节点的多数派心跳,它就被踢出集群,剩下的节点开始重新投票,选出新的主节点。
这个「2 秒心跳 + 10 秒超时」是 MongoDB 4.x 之后的默认值。也就是说,故障切换的时间下限天然就接近 10 秒。加上网络往返、投票、追平 oplog,我的实测是 12 秒左右这个数不是 MongoDB 慢,是设计上就用时间换数据安全,避免脑裂。
测试环境是三台 4 核 8G 的机器,同一内网,Debian 12,装 MongoDB 7.0,副本集名字叫 rs0,三个成员优先级设成 10/5/5。我没有直接拔电源先做了软测试,kill 掉 mongod 进程,再做硬测试,直接断电模拟机房掉电。
软测试的结果是 6 秒多切换完成,因为进程死掉时其他节点还能收到 TCP 的 RST 包,立刻知道出事了。硬测试断电就完全不同:没有 RST 包,其他节点只能靠「收不到心跳」来判断,所以老老实实等满了 10 秒,再加上选举和追平 oplog,一共 12.3 秒。
这中间最让人紧张的是从节点还要追 oplog。如果写入压力大、断电前几秒有大量写入,新主节点必须先把这段 oplog 回放完才能对外提供写服务,追平时间越长,整体切换就越久。所以那些说「MongoDB 切换只要几秒」的,多半是空库或者写入很少的场景,一有真实业务量就完全不是那回事。
触发选举之后,剩下的节点会互相发起投票,主要看两个东西:一是 priority 优先级,二是 terms 任期号。任期号高的节点优先发起选举,节点们投票给任期号更高或者相同任期里优先级更高的候选者。总票数超过半数才能当选。
所以优先级是个很关键的设计。我见过不少人一上来就把三台机器的优先级设成 1、1、1,结果哪台先收到网络抖动就可能随机当主,业务流量在几台机器之间来回跑。后来我统一改成 10/5/5,主节点永远固定在一台机器上,其余两台纯粹当备份,出问题再顶上去。
另外还有两个参数值得单独说。electionTimeoutMillis 默认 10 秒,一般不建议改小网络稍有抖动就误判失联,会造成不必要的切换;如果你的环境跨机房、网络确实慢,可以适当调到 15 到 20 秒换取稳定。heartbeatIntervalMillis 默认 2 秒,这个也别乱动,它和超时参数是配套的,改一个就得改另一个。
这是最大的坑。副本集解决的是「高可用」,解决不了「数据丢失」。oplog 是异步复制的,主节点写入返回成功时,从节点可能还没拉到这段数据。这时候主节点所在磁盘整块损坏,故障切换完成,新主节点上根本没有那段数据。
要防这个,得做两件事。第一是加大 oplog 的保留窗口,让从节点有足够时间追上mongodump 做不到这个,得靠 mongod 的 oplogSize 参数或者 --oplogSize 启动选项,给 oplog 留足 GB 级别的空间。第二是定期做全量备份加 oplog 增量备份,落到对象存储或者另一台完全独立的机器上。
我自己的习惯是每周一次 mongodump 全量,配合每小时的 oplog 增量,保留 30 天。恢复演练每季度做一次备份文件不做恢复验证等于没有备份,这话我说过很多次了,同事还是不听。
副本集跑起来之后,日常最好有个界面能随时看到谁在当主、谁是健康状态、oplog 落后多少秒。命令行当然能查,rs.status() 一敲就出来,但真正出故障的时候,你要的是一眼能看到而不是敲命令敲半天。
我一般是用带图形界面的管理工具连上去,比如 MongoDB GUI 工具这类能直接展示副本集拓扑和节点健康度的客户端,把三个节点都加进去,出问题时拓扑图上一眼就能看出谁掉了、延迟多少。工具本身不解决任何问题,就是省下排查时那几分钟。
回过头看那天凌晨的告警,其实就是有人在做每日备份或者跑大批量写入,写入尖峰把 oplog 传输拖慢,从节点追不上,触发了不必要的切换。这种情况我一般用两个手段压下去:一是把大报表类的查询打到从节点上,用 readPreference: secondary;二是给写入做限流,别让某个批处理任务把 oplog 塞满。
总之,MongoDB 副本集是一套设计得相当成熟的高可用方案,它的代价就是切换那十几秒的空窗期。你要做的就是清楚这个空窗有多长、为什么会空窗、以及空窗期间你的应用能不能扛住。把这三点搞明白了,剩下的就是照着参数默认值走,别乱调,然后老老实实做备份。
