
去年十月一个周二早上,客户那边的订单系统开始大面积超时。查下来不是代码问题,也不是数据库慢是数据盘读盘速率掉到了正常值的六分之一,IO 等待直接顶满。我们把应用临时挪到另一台机器上,才勉强把业务救回来。事后我第一件事不是查日志,是把那块盘从云主机里卸下来插上,用 SMART 工具一条条读它的历史计数。结果很扎心:Reallocated Sector Count 在出问题前三个多月就已经从 0 涨到了 312,而这段时间里,这块盘一共只做过两次自动备份其中一次还是失败的。
硬盘要坏之前,其实会说话,只是没人听。如果你手上有服务器或 NAS,除了看系统日志、盯监控面板,还有一条更直接、几乎零成本的预警通道:就是硬盘自带的 SMART 信息。硬盘哨兵 Hard Disk Sentinel(v5.20 官方版)这类工具就能把 SMART 的关键字段全量读出来,既能看当前实时值,也能看自通电以来的历史峰值峰值比当前值更重要,因为很多故障是间歇性的,只有历史最高值能暴露它。把它挂在服务器上做定期巡检,比等磁盘报警要早得多。
这篇不讲玄学,只讲三件事:SMART 到底在测什么、哪几个数值值得你设阈值、以及读完之后该怎么处理。我把平时用的命令和判断标准都写下来了,你可以直接照着在自己机器上跑一遍。
SMART 全称 Self-Monitoring, Analysis and Reporting Technology,直译就是"自我监测、分析与报告技术"。它是 ATA/SATA 硬盘协议里自带的一套机制:硬盘内部有一组专门用来监控自身状态的传感器包括磁头读写时的电流、寻道电机的工作电流、盘片转速振动、写入扇区的校验错误硬盘固件会持续采样这些数据,再按各家厂商自定义的算法,翻译成十几个"原始值(Raw Value)"和"归一化值(Normalized Value)"。
关键区别在这里:归一化值通常是厂商设定的、比值在 1~100 之间,数字越小越危险;但原始值才是真正有意义的那个,它就是"重映射了多少个扇区""累计出现了多少次 CRC 校验错误"这种绝对计数。举个例子,某块盘的归一化值显示 95,看起来很健康;但原始值那一栏写着 312,那说明它已经悄悄替换掉了 312 个坏扇区每一次重映射都是一次潜在的、可能不可逆的数据损失。
所以看 SMART 的正确姿势是:先看归一化值判断"厂商认为还能撑多久",再对原始值设自己的阈值。两套数字一起看,才能既不误报也不漏报。
一条 SMART 输出有二十多项,但绝大多数人一辈子也用不到那么多。真正值得你写进巡检脚本的,是下面这几个。
1. 5 Reallocated Sectors Count(ID 5,重映射扇区数)
这是硬盘的"坏道计数器"。盘上某个扇区物理坏了,硬盘会把它标记起来,把数据挪到备用扇区(reserve area)去,这个动作就叫重映射,每发生一次计数加一。这个数一旦持续上涨,说明盘片介质已经在衰变,是最典型的"该准备换盘"信号。我一般把 1 以上就建工单、10 以上就排换盘。注意:新盘刚出厂时这个值是 0,但如果一块二手盘开箱就是几百,那基本等于已经在鬼门关了。
2. 187 Reported Uncorrect(ID 187,上报未纠正错误)
硬盘读取某个扇区时出错了,恰好有冗余数据能救回来,这就是"未纠正错误"。它比 ID 5 更贴近业务影响重映射是盘自己悄悄处理掉了,而 187 意味着你的读请求真的返回了错误或者变慢了。业务上如果出现"偶发读取失败""文件校验对不上",先查这一项。
3. 198 Offline Uncorrectable(ID 198,离线不可修复扇区)
自检过程中发现坏到连备用区都救不回来的扇区。这个值大于 0 的盘,我建议直接判死刑,不要心存侥幸。它代表盘片上的坏区已经超出了备用扇区的兜底能力,随时可能整块消失。
4. 199 UDMA CRC Error Count(ID 199,传输层 CRC 错误)
这一项要特别小心,因为它大多数时候不是硬盘的问题,而是数据线或背板的问题。SATA 线材接触不良、背板氧化、供电纹波超标,都会让 CRC 错误飙升。硬盘本体可能完全健康,但你换硬盘也是白花钱。我的处理顺序是:先换一根线,再换一个背板口,最后才怀疑盘。
5. 194 Temperature_Celsius(ID 194,温度)
机械硬盘的正常工作温度在 30~45℃。超过 50℃ 就该查风道和风扇,超过 55℃ 寿命会明显缩短。SSD 也要看,一般超过 70℃ 要警惕过热降速。这项的价值在于它是个"前置指标"温度异常往往会先于错误计数上升。
另外还有两个常看的:231 SSD Life Left / Percentage Used(SSD 剩余寿命百分比,新盘 100%,每掉 1% 就是写入了约 1% 的设计容量)和 9 Power-On Hours(通电小时数)。前者配合你的每日写入量,可以倒推出这块盘的"死期";后者则能判断一块标着"全新"的盘是不是其实二手翻新机。
Linux 上最省事的办法是 smartctl(包名 smartmontools)。装好之后:
sudo smartctl -a /dev/sda 一次性打出全部信息,这是最常用的一条。
sudo smartctl -t short /dev/sda 触发硬盘自检(short 约 2 分钟,long 更久但更彻底),跑完用 smartctl -l selftest /dev/sda 看结果。
sudo smartctl -x /dev/sda 输出 SMART 扩展信息,包括 SATA PHY 事件计数和错误日志。
sudo smartctl -A /dev/sda 只看属性表,做脚本巡检时最常用。
要批量巡检,把所有盘列出来循环跑一遍就行:
for d in /dev/sd?; do echo "=== $d"; smartctl -H $d; smartctl -A $d | egrep "Reallocated|Uncorrect|CRC|Percentage Used|Temperature"; done
注意 smartctl -H 那行输出里的 Overall Health:它只做"通过/不通过"的粗判,是硬盘厂商自己的综合结论。个人的经验是,别太相信这一行它常常在盘已经出了几十个坏扇区之后,依然稳稳地显示"PASSED"。真正该看的是原始值。
云服务器上稍微麻烦一点,因为根盘往往被云厂商封装,你未必有权限直读 /dev/sda。这时候走两条路:一是买一块同型号的数据盘挂上去自己看;二是直接调云厂商的 API主流厂商都提供了磁盘健康查询接口(各家字段名不一样,但核心就是"重映射扇区数""是否需要更换""故障预测状态"这几个值),把它接到你的监控告警里,比在机器上装 Agent 更可靠。我自己的做法是两条都留:API 用来告警,本地 smartctl 用来在故障复盘时看完整历史。
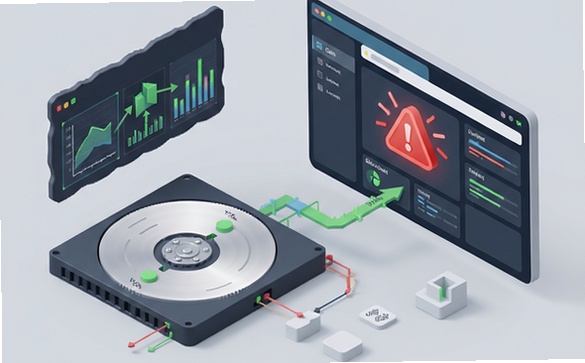
拿到巡检数据后,判断逻辑其实只有三档。
绿灯:ID 5 为 0,ID 187 和 198 也为 0,温度正常。这种盘不用管它,但建议把巡检做成周期任务,每周一次就够,很多云厂商的默认监控周期是 24 小时一次,频率反而更高。
黄灯:ID 5 从 0 涨到了个位数,或者 ID 199 单独在涨。这时候不要慌,但要立刻做三件事:确认备份是可用的(不是"备份任务跑成功了"这种意义上的可用,是真去恢复过一次的可用)、确认换盘的操作路径是通的(包括新盘到货时间、迁移窗口、业务方审批)、给这块盘挂上重点监控。黄灯阶段盘一般还能撑几个月甚至更久,但你的准备必须早于故障。
红灯:ID 198 大于 0,或者 ID 5 已经是几十甚至上百。这时候唯一正确的做法是把它当"随时会消失"来处理数据迁走、盘报废。不要试图"再观察观察",也不用去做所谓的高级修复(对机械盘而言,坏扇区修复的成功率极低,操作不当反而加速死亡)。
我自己踩过的坑是:早期只在盘"离线不可修复"后才报警,等于把预警时间压到了零。后来改成对原始值设增量阈值比如"连续两周 ID 5 增量超过 5 就告警",预警能提前一个月以上,而那次订单系统超时的事故再也没有复现过。
一、RAID 里的盘更容易被忽略。RAID 1 允许一块盘坏了系统还照跑,很多人是等 RAID 报"降级"才知道。等那时候第二块盘也开始出问题就晚了。RAID 本身不做健康巡检,你必须定期去看每一块成员盘的 SMART。
二、别把备份当成健康管理的替代品。备份解决的是"数据没了能恢复",SMART 解决的是"什么时候该主动换盘"。两者是互补关系,不冲突。真正出过事的机房,几乎都是"平时不看 SMART + 备份从来没验证过"这两个坑叠加。
三、扩容盘的 SMART 记录可能不完整。云厂商给你扩容,通常是换一块更大的新盘再迁移数据,这没问题。但如果做的是原地扩展,盘的 SMART 历史可能被清零或延续逻辑不一致。这时候历史计数就不可信了,要以云厂商的 API 监控为主。
说到底,硬盘健康监控不是什么高深技术,就是每隔一段时间把二十个数字看一遍,然后对其中两三个设好阈值和告警。它甚至不需要额外的钱smartctl 是开源免费的,看板用你现有的 Prometheus 或者云监控就能接。真正贵的是:你看晚了半小时还是三天。
