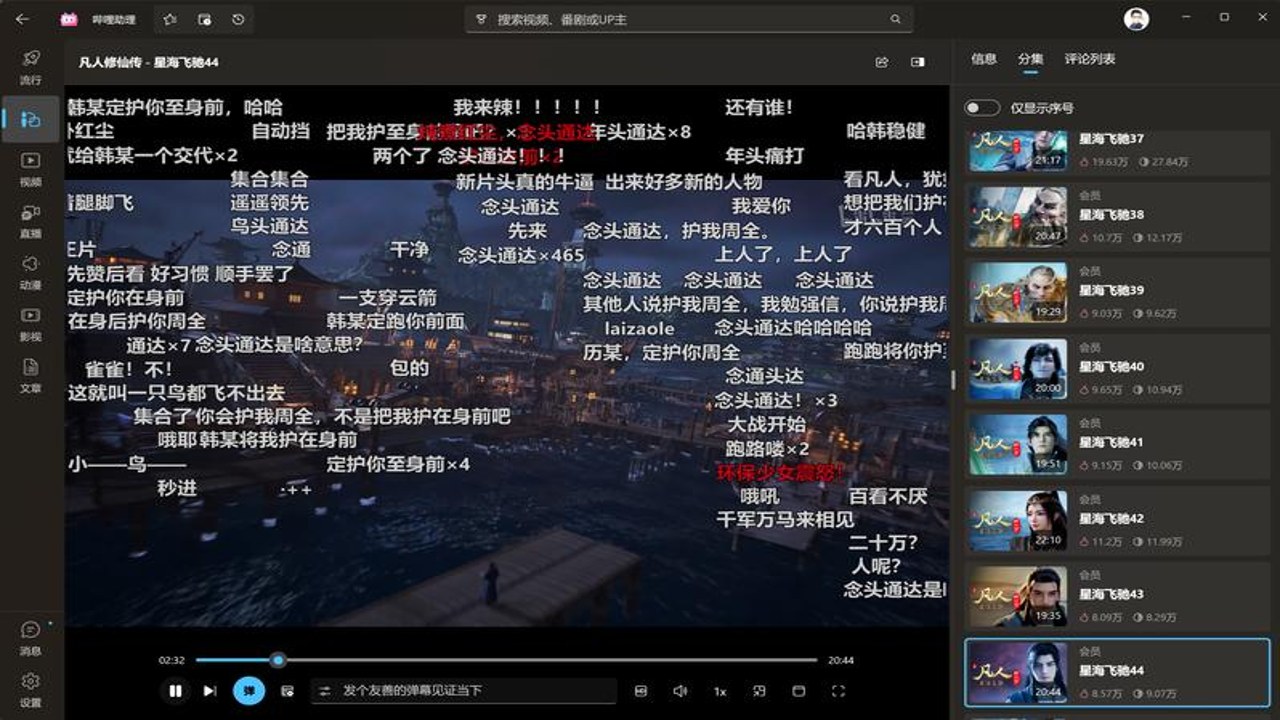
最近不少朋友在后台问,想存 B 站上的长教程或者合集视频,但一个个手动点下载太累,而且清晰度还受限。其实有个叫 **BiliGrab** 的工具专门解决这痛点,它主打高效批量获取高清资源,上手简单不折腾。今天这篇教程就聊聊怎么用这个工具,把那些几百个视频的合集一次性搞定,省时间又保画质。
很多人第一次用 **BiliGrab** 容易卡在环境配置上。其实不用太复杂,只要确保电脑有 Python 环境就行。下载完工具包后,解压打开,先别急着跑脚本,先检查配置文件里的 Cookie 是否有效。我实测过,如果没登录状态,部分高清资源会抓不到,只能拿到低清版。所以建议在浏览器里先登录 B 站,复制对应的 Cookie 填入配置,这一步很关键,直接影响能否**批量下载**成功。
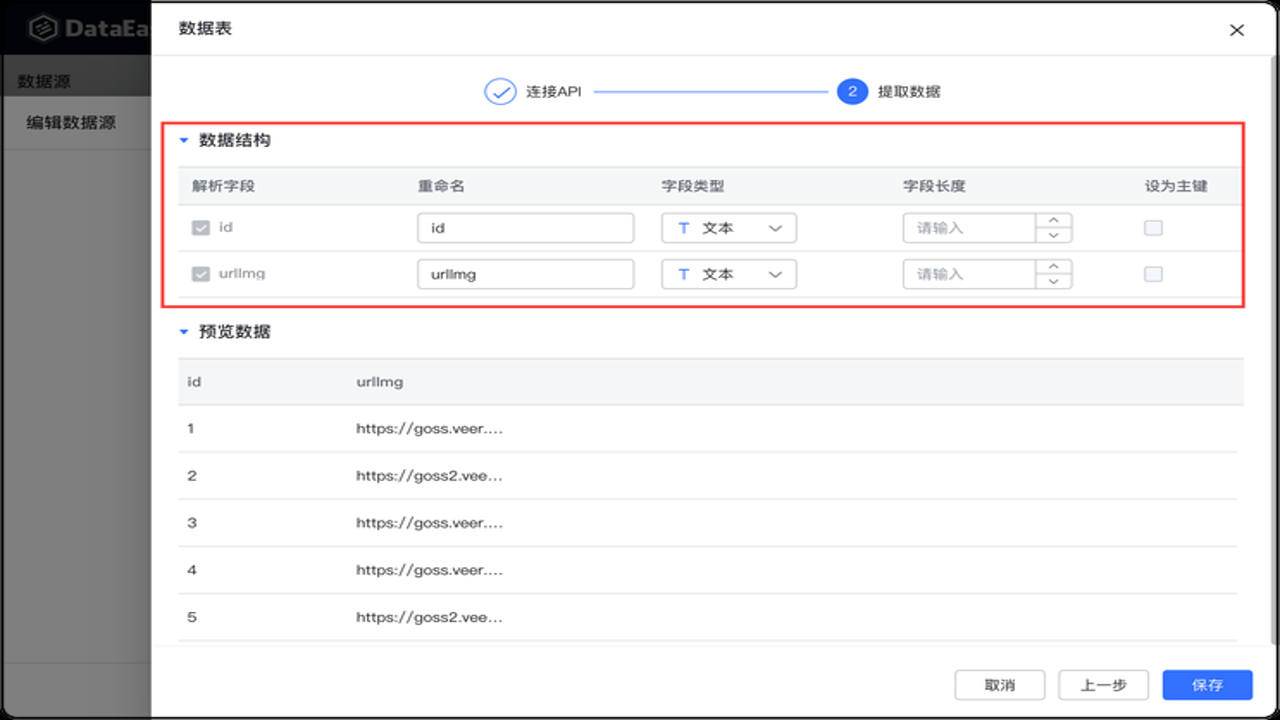
真正核心的玩法在于处理合集或播放列表。普通单视频直接粘贴链接即可,但如果是几十上百个视频的系列,手动输入太慢。**BiliGrab** 支持通过 API 接口拉取整个合集 ID,然后自动遍历每个条目。这里有个坑要注意:如果合集太大,一次性跑容易超时中断。建议分批处理,比如每次抓 10-20 个视频,或者开启断点续传功能。我在测试时发现,设置合理的并发数能提升速度,但太高会被 B 站风控拦截,导致**批量获取高清资源**失败。
既然是追求高清,默认设置可能不够用。在 **BiliGrab** 的设置里,可以指定分辨率和格式,比如强制选择 1080P 或更高。不过要注意,有些老视频没有高清源,工具会自动回退到最高可用清晰度。另外,下载完的文件命名规则最好自定义一下,避免文件名乱码或重复覆盖。对于需要长期保存的用户,建议按日期或系列名称整理文件夹,这样后续查找方便。这也是**高效批量获取**的一部分,不仅快,还要整理得干净。
总的来说,**BiliGrab** 不是那种傻瓜式一键工具,但一旦配置好,它的效率远超手动下载。适合那些经常需要囤积教程、纪录片或动画合集的用户。如果遇到个别视频抓失败,通常是源本身限制或 Cookie 过期,重新刷新登录状态再试即可。掌握这些细节,就能真正利用这个工具实现**批量获取高清资源**的目的。
