pdf提取表格内容源码,一个pdf提取表格内容的源码,由Python语言编写,参考文档为教育部阅读指导目录,用户可以通过源码原理来制作能提取任意表格内容的源码,下面给出这款pdf提取表格内容的源码资源,有需要的朋友们可以参考学习。
源码程序由论坛用户制作分享。

一个从pdf文档中提取出表格数据,并另存为excel文件的python程序
教育部基础教育课程教材发展中心首次向全国中小学生发布阅读指导目录
http://www.moe.gov.cn/jyb_xwfb/gzdt_gzdt/s5987/202004/t20200422_445605.html
最下面的附件
pdf中按小学、初中、高中推荐了三套生阅读指导目录。
我们根据页码,来分别存为3个EXCEL文件。
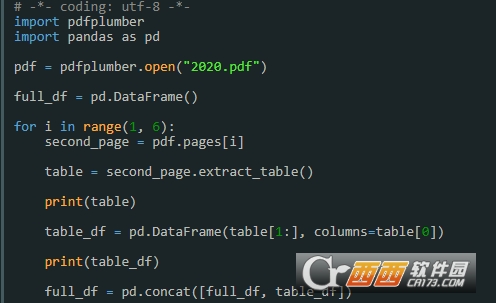
# -*- coding: utf-8 -*-
import pdfplumber
import pandas as pd
pdf = pdfplumber.open("2020.pdf")
full_df = pd.DataFrame()
for i in range(1, 6):
second_page = pdf.pages[i]
table = second_page.extract_table()
print(table)
table_df = pd.DataFrame(table[1:], columns=table[0])
print(table_df)
full_df = pd.concat([full_df, table_df])
full_df.to_excel('小学段.xlsx')
full_df = pd.DataFrame()
for i in range(6, 11):
second_page = pdf.pages[i]
table = second_page.extract_table()
print(table)
table_df = pd.DataFrame(table[1:], columns=table[0])
print(table_df)
full_df = pd.concat([full_df, table_df])
full_df.to_excel('初中段.xlsx')
full_df = pd.DataFrame()
for i in range(11, 15):
second_page = pdf.pages[i]
table = second_page.extract_table()
print(table)
table_df = pd.DataFrame(table[1:], columns=table[0])
print(table_df)
full_df = pd.concat([full_df, table_df])
full_df.to_excel('高中段.xlsx')
开发者其他应用

七猫免费阅读小说最新版41.6M234049人在玩七猫免费阅读小说下载安装app,七猫免费阅读小说app不一样的小说阅读神器,这里有着海量丰富小说应用资源,你想看的小说通过强大搜索引擎一键搜索即可,主要的是阅读小说还能够获取红包现金奖励哦。
下载奇热漫画app安卓版25.5M13451人在玩奇热漫画是一款非常不错的漫画阅读软件,具有很多强大的阅读功能,奇热漫画app实时为你更新全网最新最热的动漫资源。平台拥有海量精彩漫画,官方正版漫画
下载奇热小说app24.8M234499人在玩安卓奇热小说app是专为众多爱看小说的人士提供的手机看小说的软件,省流量极速免费看小说,海量热门小说任你看,喜欢小说的小伙伴不要错过,赶快下载奇热小说网手机版客户端体验吧
下载2022快看漫画App最新版69.0M51448人在玩2022快看漫画,相信许多玩微博的小伙伴们都已经知道这款APP了。吵架归吵架,至于这款快看漫画App到底做得怎么样,只有试过才知道!
下载豆瓣阅读客户端app70.2M9579人在玩豆瓣阅读app是一款为豆瓣的用户们量身定做的APP,在豆瓣阅读这里你可以看到更加符合豆瓣用户喜好的各类文字作品,而且目前书籍依然在持续增长中。
下载追书神器官方版70.1M19679人在玩追书神器2022最新版是一款超级强力的小说导读助手,目前几大热门的小说连载网站均有关联,你可以通过它方便地寻找自己喜欢的书籍。
下载腾讯动漫71.9M13609人在玩腾讯动漫寒假档,许多大人们认为动漫就是小孩子看的东西,但是大概从80后开始,动漫就成为了许多人生活中的一部分,如果你喜欢看动漫,可以来腾讯动漫吧,这里有最新动漫更新视频
下载书旗小说免费版本32.7M22553人在玩书旗小说免费版下载安装,书旗小说免费版本是一款以书旗网海量小说为基础的在线/离线阅读器,集合在线阅读、本地阅读、书包下载、自动书签、智能搜索、阅读设置等多项人性化功能。
下载搜狗阅读器app19.5M6809人在玩搜狗阅读是搜狗公司依托于搜狗搜索的丰富资源,为安卓用户打造的移动阅读应用产品。搜狗阅读海量图书即搜即看,新闻大事掌握在手,更有离线缓存、精品推荐、更新提醒等功能,让您随时随地享受阅读的快乐。
下载起点读书app新版本202237.2M11875人在玩起点读书app新版本,又名起点看书,是起点中文网推出的一款阅读软件。它支持本地阅读并提供起点在线书库,具备多种格式的解析阅读功能
下载