
我到现在还记得那天早上打开后台看到的那一屏数据。业务是给一家连锁门店做订单中转,每天凌晨两点有一条cron负责把前一天门店上传的流水同步进订单表。这条任务平时跑得挺稳,一个多月没出过岔子。结果那天早上客服给我发消息,说某个门店的订单对不上账,我进去一查,订单表里同一批流水躺着两份,重复了三千多条。物流那边只收到了一次发货通知,门店那边却看到两笔待发货订单,钱差了一万多。
后来排查发现,那台跑任务的机器在凌晨一点五十八分做了一次系统更新,重启之后有些服务带了对账补偿逻辑,而 cron 服务本身也随着机器起来重新拉了一次。结果就是同一条定时任务,在 1:58 被拉起来执行了第一遍,任务跑到一半机器重启,重启后又被拉起来执行了第二遍。第一遍其实已经把三分之二的数据写进去了,只是还没打完成功标记,所以第二遍从头再来,把已经写过的部分又写了一遍。
如果你也在服务器上跑定时任务,或者正准备给自己的调度系统加一层保护,这两家可以先看看:狗云DOGYUN(高性价比云服务器,机型齐全,适合多机部署调度节点)、RackNerd(全球 VPS,Windows 与 Linux 机型可选,多台机器铺调度很方便)。机器先备好,容灾和去重方案再动手,能少走很多弯路。
很多人对 cron 的认知是"到点自动执行",这句话对也不对。对的是它确实会到点拉起进程,不对的地方在于它只管拉起,不管上一次是否结束。默认的 crontab 只有一行命令,比如 0 2 * * * /usr/bin/php /data/sync/sync.php,只要 crond 进程活着,到了两点就会 fork 一个新的 shell 去执行它。如果这个任务执行了 40 分钟,而 crontab 写的是每小时一次这在写 cron 的人眼里可能算"低频"那第 2 点 40 分的时候,第二个实例就已经在跑了。两个实例共享同一个数据库,同时往订单表里写东西,重复几乎是必然的。
更麻烦的是机器重启这件事。systemd 的 timer、supervisor 的 cron 扩展、各家云厂商的调度服务,很多都带"错过的任务补跑"逻辑。设计者的出发点是好的机器重启错过了凌晨两点的任务,醒来之后应该补上,不然数据不就漏了?但如果补跑逻辑和正常调度撞在一起,或者补跑本身又触发了两次,你得到的就是重复。补跑机制保证了不丢,幂等机制保证了不重,这两件事必须分开设计、同时存在,很多人只做了前者。
如果你的任务只跑在一台机器上,其实问题很简单,Linux 自带的 flock 就能解决。核心思路是:执行前先拿一把文件锁,拿不到就直接退出,让正在跑的那个实例继续。
写法大致是这样:
*/10 * * * * /usr/bin/flock -n /var/lock/sync.lock /usr/bin/php /data/sync/sync.php
-n 是关键参数,意思是拿不到锁就立刻返回失败而不是排队等待。如果不加这个参数,第二个实例会一直阻塞等锁,等第一个跑完它再接着跑一遍重复照样发生,只是不并发而已。加上 -n 之后的行为才是我们想要的:同一时刻只允许一个实例在跑,错过的这一轮直接放弃,等下一个周期。
顺手再说个细节,flock 锁的是文件描述符,进程退出锁自动释放,不会像某些自研的锁那样因为进程被 kill 就留下永久锁。但如果你把这个命令写成 flock /var/lock/sync.lock sh -c "php a.php && php b.php",要留意子进程的生命周期,锁的释放时机是以 flock 进程为准的。

单机 flock 挡不住的场景是:你有三台机器都跑着同一个 cron,做的是主备或者分片。这时候三台机器各自 flock 自己本地的文件,互不干扰,三份任务齐刷刷跑起来。这时候需要的是一把跨机器的锁,也就是分布式锁。
最省事的做法是直接用数据库当锁。核心逻辑是:在一个专门的对账表里插入一行带唯一索引的记录,插入成功就意味着我抢到了执行权,其他机器插入会撞唯一索引失败,直接退出。
表结构大概长这样:
CREATE TABLE task_lock (
task_name VARCHAR(64) NOT NULL,
holder VARCHAR(64) NOT NULL,
acquired_at DATETIME NOT NULL,
expire_at DATETIME NOT NULL,
PRIMARY KEY (task_name)
);
抢锁就是 INSERT INTO task_lock ... ON DUPLICATE KEY UPDATE,但这里有个必须处理的细节:锁要有过期时间。如果持有锁的那台机器直接宕机,锁行还留在表里,其他机器就永远抢不到了,任务从此再也不会执行。所以在 UPDATE 语句里要带上条件,只有当 expire_at < NOW() 时才允许抢占,正常的持有者不会被踢掉,僵死的持有者则会在超时后被后来者接管。
另外,锁的持有者要带机器标识和时间戳,出问题时一眼能看出是谁持的锁、拿了多久。分布式锁用 Redis 的 SET NX EX 或者 ZooKeeper 的临时顺序节点也能做,思路是一样的:要么拿到锁干活,要么看着别人干活,两边都不许同时干。
锁只能保证"同一时刻只有一个在跑",但保证不了"只跑过一次"。机器在中途崩了、任务被 kill 后被 supervisor 自动拉起、下游接口超时后你重试了一次这些场景下锁都可能失效或者根本没起到作用。所以最后一道防线必须落在业务层。
幂等的做法是给每一次业务操作生成一个稳定的唯一标识。最常见的就是业务主键本身,比如门店流水号、订单号、或者用请求参数算出来的哈希。这个标识在写入数据库时作为唯一索引的一部分:
ALTER TABLE orders ADD UNIQUE KEY uk_source_flow (source_flow_id);
这样第二次插入相同流水号的时候,数据库会直接抛出唯一键冲突,代码捕获异常跳过即可。数据永远不会重复,而且这个保障在数据库层面,不依赖你的应用进程状态。我那次事故的最后一道补丁就是这个:在订单表加了一列来源流水号并加了唯一索引,然后代码里加了唯一键冲突的捕获。改完之后同样的脚本再跑两遍,订单表行数纹丝不动。
如果表结构不好改,比如是老系统没法加索引,那就在业务表旁边加一张去重表(flow_id 唯一),插入去重表成功才允许写业务表,同样能起到一样的效果,只是多了一次写入。
还有一点要提醒:下游调用的幂等和本地入库的幂等是两回事。你本地写库有唯一索引保护,但你调第三方发货接口的时候,如果对方没有幂等键,你重试就可能发两次货。所以推给下游时,请求里要带上你的幂等键,让对方能识别重复请求;如果对方不支持,至少要自己记录"已推送"状态,重试前先查一遍。
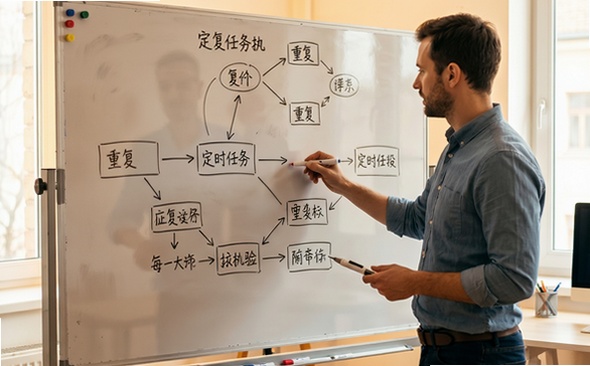
回到开头那次事故,我现在的处理方式是四层叠在一起:
第一层,单机用 flock 防重叠,cron 命令最外层包一层 flock -n,保证同一台机器上不会有两个实例并发。第二层,多机用带过期时间的分布式锁抢执行权,三台机器里只有一台能拿到锁。第三层,业务层幂等键,写入时用唯一索引兜底,重复数据在数据库层就被挡掉。第四层,状态标记与补偿,任务执行成功后写一条带日期的执行记录,下一次跑之前先检查今天是不是已经成功过,成功就跳过;失败或者状态不明的,走人工确认或者补跑流程,补跑本身因为有前三层保护,跑两遍也不会产生重复数据。
这四层不是四选一。flock 挡不住多机,分布式锁挡不住崩溃重启,唯一索引挡不住下游重复推送,状态标记挡不住历史数据的修复。叠起来用,每一层都有它挡不住的漏洞,下一层正好补上。
顺便提一句,排查这类问题的时候,别一上来就怀疑 cron 本身。最快的定位方式是看两个地方:一是数据库里重复数据的特征,如果重复的记录 created_at 差了几十秒到几分钟,基本就是并发执行无疑;二是任务的执行日志,如果日志里有两段开头时间接近的记录,那就是两次拉起。日志这块我建议在任务脚本里把开始时间、结束时间、批次号、处理的记录数都打出来,出问题时这几行日志能省你半天时间。
最后提醒一句,测试环境验证重复执行一定要手动来一次:在同一个窗口内手动触发两次任务脚本,确认第二遍被挡住或者空跑,确认重复数据的数量为零。这件事做一次,比上线后靠对账发现问题便宜太多。
