
去年年底我接手了一批散在三个机房的机器,12 台,清一色 Ubuntu 22.04,跑着同一套 Nginx + PHP-FPM + Redis 的业务集群。那天产品提了个需求:把 Nginx 的连接数上限从 1024 改成 2048,同时给新加的两台机器也铺同一份配置。听起来是件小活,我打开 FinalShell 准备一台台连上去改结果就是那天晚上,我在这 12 台机器上敲了将近 3 小时。有几台连不上要重试密钥,有几台改了忘重启,还有两台的配置我干脆贴串行号贴错了,回滚重来。凌晨一点活干完,人是麻的,但心里清楚:这活儿根本不该这么干。
手上机器超过十台、还在一台台手动 SSH 改配置的朋友,这两家可以关注一下:狗云DOGYUN(高性价比云服务器,机型多,开机即可用)、Zenlayer(全球多地区节点,多机房批量纳管很方便)。机器数量一多,每多开一台就多一份重复劳动,选机器的时候把批量运维的便利性也算进去,比事后补救省事。
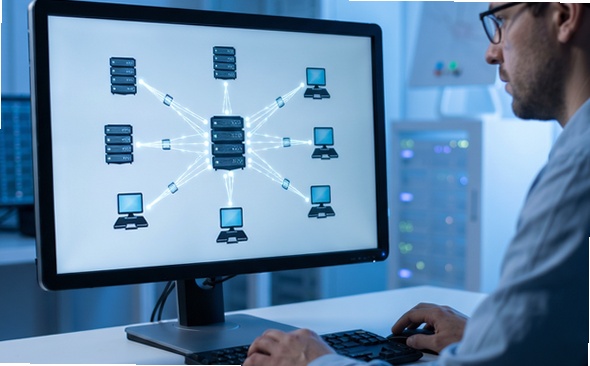
很多人以为 Ansible 就是个"批量执行命令"的工具,这理解不算错,但只对了一半。它真正的价值是三点:第一,幂等同一个 playbook 跑两遍,第二次它会自动识别"已经是你要的状态",跳过不动;第二,声明式你描述的是"这台机器 nginx 的 worker 数应该是 4",而不是"去执行 sed 命令改一下",至于它用 sed 还是 cat 重写文件,那是 Ansible 自己的事;第三,清单化管理所有机器写在 inventory 里,谁是什么角色、装什么软件、开什么端口,一份文件说了算,换机器、加机器只改这一份清单。
落到我那 12 台机器上,之前 3 小时的手工活,换成 Ansible 之后,从"写第一份 playbook"到"全部跑通",前后不到 10 分钟而且这 10 分钟里有一大半是在写 playbook,不是执行。配置是同一份,12 台机器跑出来的结果完全一致,不存在"第 7 台忘了重启"这种事。
很多人第一次用 Ansible,会直接在命令行敲 ansible all -m ping 觉得挺酷,然后就卡在下一步:怎么让不同的机器做不同的事?我一开始也走了弯路,直接把 12 个 IP 往命令行里一贴,参数一长就报错。后来才明白,Ansible 的正确用法是先写一份主机清单,把机器分组。比如下面这样:
[webservers]\nweb-01 ansible_host=10.10.1.11\nweb-02 ansible_host=10.10.1.12\n\n[redis]\nredis-01 ansible_host=10.10.2.21
分完组之后,下发配置的时候一句 ansible webservers -m template -a "src=nginx.conf.j2 dest=/etc/nginx/nginx.conf" 就完事了。而且这份 inventory 可以直接进 Git,谁改了、加了哪台机器、什么时候改的,git log 里全有,比任何管理文档都靠得住。
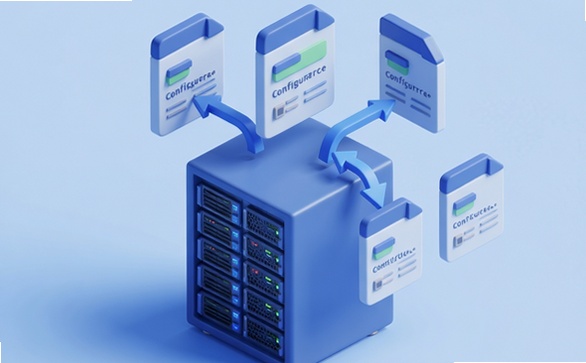
配置不统一这件事,比配置发错更隐蔽。我第一次用 Jinja2 模板,把 worker_processes 直接写死在模板里,后来想给 4 核机器设 4 个、8 核机器设 8 个,才发现模板根本没法区分机器。正确的做法是分两层:host 变量写在 inventory 里,描述这台机器自身的属性(CPU 核数、机房、角色);group 变量写在 group_vars 里,描述这一组机器的共同约定。模板里用 {{ ansible_processor_vcpus }} 这种变量去取值,而不是把数字写死。
还有个细节:模板改完必须让 Ansible 知道文件变了,不然它会认为"当前状态已经符合预期"从而跳过。我现在的习惯是模板任务统一加上 notify: reload nginx,改完配置自动重载,这个小技巧能省掉一半"改完没生效"的排查时间。
批量执行最崩溃的瞬间,是跑到第 8 台突然停下来等你输密码。Ansible 走 SSH,默认不会自动去你本地 SSH agent 里取密钥。所以第一步必须先做免密:在控制机上 ssh-keygen 生成密钥对,然后用 ssh-copy-id 把公钥推上去这一步也是可以写成 Ansible 任务的(用 authorized_key 模块加 become),但第一次还是手动推一遍更省事,至少确认密钥本身没问题。
配好之后还有两个细节要检查:一是 /etc/ansible/ansible.cfg 里把 host_key_checking = False 打开,不然第一次连每台机器都会问你"这个指纹对不对",12 台就是 12 次交互;二是把 timeout 和 retries 配好,机器偶尔抽风的时候它自己重试,而不是整批任务直接 abort。
这条是最贵的。我有个朋友把改防火墙规则的 playbook 直接对生产全量跑,结果因为一处 iptables 规则写错,把自己的 SSH 端口也拦了,12 台机器当场全断,只能进机房接显示器救火。从那以后我形成了铁律:任何 playbook,先在同环境的测试机上跑一遍,确认输出没问题,再加 --check 或者 --diff 看清楚它到底要改什么,最后才全量。
ansible webservers -m template -a "src=nginx.conf.j2 dest=/etc/nginx/nginx.conf" --check --diff
这个命令只做预演,不实际写文件,会把"这台机器上这个文件将被改成什么样"的 diff 打出来。我一般会把这个 diff 存到文件里存档,出问题的时候有据可查。
批量操作最怕的不是失败,而是"不知道成没成"。Ansible 输出的绿色 yy 确实好看,但日志一长就没人看。我的做法是在 playbook 结尾加一段 shell 或 uri 任务做健康检查,比如 nginx -t 验证配置语法、systemctl is-active nginx 确认服务活着、curl -s -o /dev/null -w "%{http_code}" http://127.0.0.1/ 看返回码是不是 200。只要有一台不健康,任务就标红,我再去单独看那台的输出。
另外强烈建议给 Ansible 配一份 ansible.cfg 里的 log_path,把所有输出落盘。机器一多、任务一长,日志就是你唯一的证据链。
如果看完上面的坑觉得有点吓人,其实上手没那么复杂,我把我现在的流程完整说一遍,你照着走基本不会出事:
第一步,装 Ansible(控制机上 apt install ansible),配置好免密 SSH 和 host_key_checking。第二步,写 inventory,按角色分组,标清每台的 host 和主机名。第三步,先写一个只有 ping 和 debug 的 playbook,确认"能连上、能看变量",这一步花不了五分钟,却能挡掉八成的连接问题。第四步,把要改的配置写成 Jinja2 模板,先 --check --diff 预演,再真跑。第五步,跑完做健康检查,确认全绿再收工。
把这五步固化下来以后,我手上现在 30 多台机器,改一次 Nginx 配置的耗时从"半小时起"变成了"十分钟以内"。而且不管多少台机器,出来的结果都是同一份,不会再有第 7 台漏改的情况。批量运维这事儿的核心从来不是工具多花哨,而是把重复劳动变成可复用、可回滚、可审计的流程。
顺便说一句,如果你还停留在一台台 SSH 进去敲命令的阶段,建议先配好 FinalShell 这类终端管理工具过渡一下连接历史、会话保存、批量窗口这些功能能让你在还没搭好 Ansible 之前少受点罪;等 Ansible 那套跑顺了,再把这些一次性动作收敛进 playbook 里,这块我推荐 FinalShell(服务器管理) 做日常连接和排障。
