
网站做大了以后,数据库往往是最先顶不住的那个。订单表一天涨几百万行,报表查询一跑就是几十秒,业务还没 complaining,磁盘 IO 先满了。这类问题后来大家都想明白了单台数据库机器迟早有天花板,得上主从。于是你会看到很多人在这一步卡住:配置文件改了一堆,从库的数据就是对不上;勉强跑起来了,过几天延迟飙到几千秒;或者更糟,主库一挂,从库因为丢了个事务不敢切换,业务直接停摆。
这篇不打算写一份抄文档的教程,而是按我自己踩坑的顺序,把 MySQL 主从复制的原理、三种复制模式、搭建步骤、延迟排查和读写分离落地完整讲一遍。看完你应该能自己判断:我这个站到底需不需要主从?如果需要,主从该怎么搭、读写分离该不该上、故障了怎么切回来。
如果你的站正打算给数据库做主从复制,或者已经在跑主从但延迟压不下来,机器这块可以先看看这两家做参考:RackNerd(全球VPS,特价常推)、狗云DOGYUN(高性价比云服务器,多机房可选),主从两台建议起步就上 2 核 4G 的配置,MySQL 8.0 本身吃内存不多,反而是日志和 buffer pool 更值得留够余量。
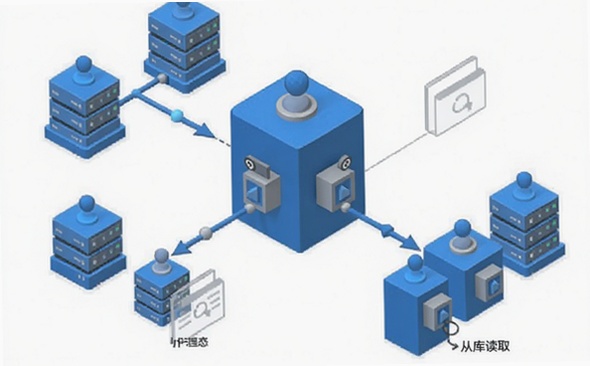
先搞清楚原理,后面所有配置都好理解。MySQL 主从复制靠的是 binlog(binlog 是数据库的二进制日志,记录了所有对数据的增删改操作),流程是这样的:
主库上有个 dump 线程负责把 binlog 推出去;从库上有个 IO 线程负责去接;再有一个 SQL 线程负责把接到的日志重放一遍到从库自己的数据文件里。就这三个线程,构成了最经典的「一主一从」结构。多从库的话,就是每个从库各自派一对 IO 线程和 SQL 线程去主库拉,主库那边其实是多个 dump 线程在推。
这里有个细节很关键:默认情况下这个过程是异步的。主库写完 binlog 就告诉客户端"我写好了",至于从库有没有收到、有没有重放,主库根本不管。这就是主从延迟的根本来源中间隔了一个网络传输 + 日志落盘 + 重放的时间差,网络抖一下或者从库磁盘慢一点,延迟就上去了。
异步复制(Asynchronous)就是上面说的默认模式。主库不等从库确认就返回,优点是性能最好,主库写入完全不受从库影响;缺点是极端情况下主库挂了、还没传过去的 binlog 就丢了,会丢数据。中小站点绝大多数场景用异步就够了,别一上来就追求强一致。
半同步复制(Semi-Synchronous)是 MySQL 5.5 之后引入的折中方案。主库写完 binlog 后,会等至少一个从库确认"我收到了"(注意是收到,不是重放完)才告诉客户端成功。这样至少保证了 binlog 不丢,但代价是主库每次提交要多等一个网络往返,延迟会明显上升。如果你的业务不能接受偶发丢数据,但又不想上分布式数据库,半同步是比较务实的选择。配置也简单,主从两端各加一个插件参数,然后 rpl_semi_sync_master_enabled=1 之类的开关打开就行,具体参数名不同版本略有差异,装之前先查一下自己版本的文档。
组复制(Group Replication)是多主结构的方案,每个节点都可以写,靠 Paxos 变种协议保证各节点数据一致。听起来很美,但它的复杂度、网络要求(节点间延迟最好低于几毫秒)、运维门槛都很高,而且冲突检测失败会导致事务被回滚。对于绝大多数站长来说,这属于过度设计除非你在做金融级别的强一致系统,否则不建议碰。
实际选型建议很直接:中小业务用异步;丢了数据不能忍用半同步;多机房跨城场景优先考虑异步 + 半同步混合,别上组复制。
先说环境。假设主库 192.168.1.10,从库 192.168.1.20,两台都装 MySQL 8.0,版本尽量保持一致,跨大版本复制会有坑。
第一步,配主库的 my.cnf。最关键的三行:
server-id=1 唯一标识,不能重复。
log-bin=mysql-bin 打开 binlog,这是复制的根基。
binlog_format=ROW 强烈建议用 ROW 格式。默认的 STATEMENT 格式在某些 SQL 下会产生不一致,而 MIXED 格式行为不可预测。ROW 记录的是行变更,主从几乎不会因为执行计划不同而跑偏。代价是 binlog 体积变大、磁盘占用高一些,但对现在的磁盘价格来说完全可以接受。
顺手再加两个参数:binlog_expire_logs_seconds=604800(保留 7 天,防止磁盘被 binlog 撑爆),以及如果磁盘是 SSD 建议 sync_binlog=1 保证 binlog 每次提交都落盘。
第二步,配从库。server-id=2,同样打开 log-bin(从库开 binlog 是为了将来做级联复制或者随时能升级成新主库),并把 relay-log 相关参数配好。从库上要关掉 read_only=OFF 之外的一切自动写入行为具体是把 super_read_only=ON 打开,防止误操作在从库上写入导致数据不一致。
第三步,在主库创建复制账号并授权:
CREATE USER 'repl'@'%' IDENTIFIED BY '你的强密码';
GRANT REPLICATION SLAVE ON *.* TO 'repl'@'%';
FLUSH PRIVILEGES;
这个账号密码务必用强密码,因为它拥有几乎全库的权限。生产环境建议限制来源 IP,比如 'repl'@'192.168.1.%'。
第四步,在从库执行 CHANGE MASTER TO 指定源。MySQL 8.0 用的是 CHANGE REPLICATION SOURCE TO,5.7 及以前是 CHANGE MASTER TO,参数写法有差别,别搞混:
CHANGE REPLICATION SOURCE TO
  SOURCE_HOST='192.168.1.10',
  SOURCE_USER='repl',
  SOURCE_PASSWORD='你的强密码',
  SOURCE_LOG_FILE='mysql-bin.000001',
  SOURCE_LOG_POS=154;
其中 LOG_FILE 和 LOG_POS 就是"从主库的哪个位置开始拉"。如果库里有旧数据需要跳过,可以先 SET GLOBAL GTID_PURGED 或者直接指定一个早就存在的位置。更省事的做法是用 --master-data=2 参数做一次全量备份,然后从备份里直接读出正确的位点信息。
第五步,启动复制并验证:
START REPLICA; SHOW REPLICA STATUS\G
重点看三个字段:Replica_IO_Running 和 Replica_SQL_Running 都得是 Yes,Seconds_Behind_Source(延迟秒数)得是 0 附近。如果 IO 线程是 No,多半是网络不通或者账号密码/权限有问题;如果是 SQL 线程 No,去看 Last_SQL_Error,多半是有什么数据在从库上跟主库冲突了。
主从延迟是主从复制里最磨人的问题。我一般按下面顺序查。
元凶一:从库跑了大查询。从库上如果有个没加索引的 SELECT * FROM orders 扫了几百万行,这个查询会把 IO 和 CPU 占满,SQL 线程重放 binlog 排在后面,延迟立刻飙到几千秒。解决办法很直接:用 SHOW PROCESSLIST 看从库在跑什么,把那个大查询杀掉;长期方案是给从库加 --slave-parallel-workers 并且开启 --slave-parallel-type=LOGICAL_CLOCK,让多个线程并行重放。
元凶二:主库大事务。主库上一个 DELETE FROM logs WHERE created_at < '2024-01-01' 删了三千万行,这个操作在 binlog 里如果开的是 ROW 格式就还好(记录成行事件),但从库重放起来依然要花大量时间。更麻烦的是主从是串行依赖的:只要这个大事务没重放完,后面的全部排队。应对办法是拆分成小批次分批提交,或者在低峰期做这种清理。
元凶三:单线程重放太慢。MySQL 5.6 之前从库只有单线程重放,主库用多线程写、从库用单线程读,天然不对称。从库积累 binlog 越积越多。5.6 之后虽然有并行复制,但默认配置往往没开到位。MySQL 8.0 的并行复制已经相当成熟,把 replica_parallel_workers 设成 4 或 8,replica_parallel_type 用 LOGICAL_CLOCK,绝大多数场景延迟都能压到秒级以内。
另外两个排查手段值得记住:一是 SHOW REPLICA STATUS 里的 Retrieved_Gtid_Set 和 Executed_Gtid_Set,两者的差值就是还没重放的 binlog 量,比看秒数更准;二是用 mysqlbinlog 工具或者 pt-heartbeat 这种第三方心跳表来实时打点测量延迟,后者需要在你自己的表里插一行时间戳定时刷新,然后对比主从两边的差值,是目前最精准的延迟测量方式。
主从建好之后,很自然会想到:既然读多写少,能不能把读请求分到从库上去?答案是能,但有三个前提必须想清楚。
前提一,业务能接受读到旧数据。用户在主库下单,立刻刷新页面查询订单,如果这次读走了从库,而从库还没追上,会查不到这条订单这是典型的「读己之写」问题。解决办法常见有三种:写完主库后先读主库(同一请求内路由到主库)、用 GTID 等待从库追上指定位点、或者在业务层做短暂缓存。个人项目我一般选第一种,简单直接。
前提二,有一层代理或者中间件来做路由。常见方案分两类。应用层中间件像 ShardingSphere、MyCat,自己实现了 JDBC 协议层,能做分库分表也能做读写分离。代理层像 ProxySQL,它自己就是个 MySQL 协议的服务,你的应用把连接指向它就行,配置灵活。轻量方案也可以自己写:如果只有几个固定的读接口,在代码里用两个数据源,手动指定哪个查询走从库。哪种好取决于你的项目规模,别为了一个中小站上全套中间件。
前提三,主从延迟在可接受范围内。如果延迟经常几十秒,读写分离只会放大问题。所以顺序应该是:先把主从跑稳、延迟压到秒级,再考虑读写分离。
顺便说一个常见的误区:读写分离不等于性能自动提升。如果你的慢查询是因为缺索引、因为表太大、因为没走对执行计划,那把查询分散到两台机器上,每台都还是慢,只是把慢变成了两倍慢。读写分离解决的是并发压力,不是单条查询效率。
主从搭好之后,真正的考验是主库挂掉的那一刻。手写切换脚本很容易出错,现在更常见的做法是用 Orchestrator、Patroni 或者 MHA 这类工具来做自动故障转移。它们做的事情大同小异:探测主库是否真的挂了(不是简单 ping 一下,要确认能不能写)、把某个从库提升为新主库、调整其他从库的复制指向、通知应用层切换连接。
需要特别注意的是脑裂问题:如果只是网络断了,主库其实还活着并继续接受写入,而切换工具把从库提成了新主库,两边都在写,数据就分叉了。成熟的工具会用虚拟 IP 漂移或者 raft 协议投票来避免这个问题。如果你要自己搞,一定要有 fencing 机制比如提升新主库前先把老主库的网卡或者服务停掉。
另外提醒一句:自动切换的前提是你有备份。主从解决的是高可用,解决不了误删数据。上个月有人手滑执行了一句 DELETE FROM orders WHERE status = 0,这条语句同样会忠实地复制到所有从库上。所以定期做备份、并且验证过备份能恢复,比主从本身重要得多。
不是所有站都需要主从。以下几个信号说明你可能上早了:日增行数不到几千行、数据总量几个 G 以内、并发请求数还在两位数、单条慢查询都能拖垮但加个索引就好、机器配置还停留在 1 核 1G。这个阶段最划算的做法是加索引、改查询、必要时上读写分离(虽然叫读写分离但其实就是单库加个从库读),或者干脆升一档配置。
反过来,如果你的库已经单表超过五千万行、写入 TPS 稳定过两千、或者业务已经不能接受几分钟的停机,主从就是必须做的功课了。
最后说一句心态上的事。主从复制这东西,配置只要十分钟,调通可能要三天。我第一次搭的时候,为了一个 server_id 没配对排查了整整一个下午;后来为了 Seconds_Behind_Source 一直是 NULL 翻遍了半本文档,最后发现是 MySQL 8.0 改成了 Replica_IO_Running。这些都是学费,踩过就都成了经验。如果你也是刚开始折腾这套东西,希望这篇能让你少走几天弯路。
