
做过一阵后端之后,多半都遇到过这种场景:用户点了提交,接口里要发一条短信、扣一次库存、写一条操作日志、把商品同步到搜索索引、通知一遍数据分析平台。每一件事都不难,难的是它们串在一起短信接口抖一下,用户就得等两秒;索引重建跑三分钟,整个下单接口就卡在那儿。把这段逻辑拆到后台异步去做,响应立刻就快了。而承接这些异步任务的东西,就是消息队列。
正在做业务解耦、或者要给后端配一套消息中间件的朋友,机器本身可以先看看这两家:狗云DOGYUN(高性价比云服务器,多机房可选)、RackNerd(全球VPS,内存配置可选空间大)。消息队列本身吃内存和磁盘 IO,机器别配得太抠,否则 broker 反而成了瓶颈。
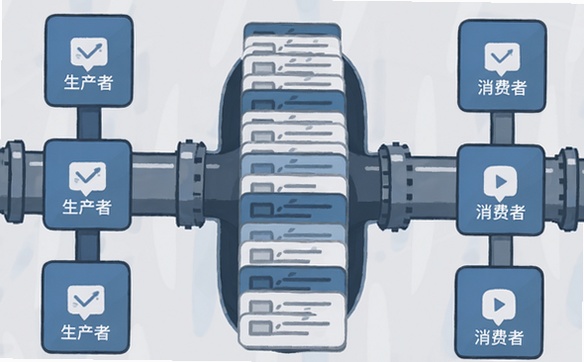
在选型之前,先把消息队列的三个核心价值理解透,不然容易被各种参数绕晕。
第一是解耦。原来发送方要直接调用接收方,五个下游就得写五份调用逻辑,加一个下游要改一次上游代码。换成队列之后,发送方只管往队列里扔消息,下游自己订阅消费。加十个下游,发送方代码一行不动。这是消息队列最本质的价值,也是它最被低估的地方。
第二是削峰。平时每秒 20 个订单,下游服务扛得住;突然来一波活动,每秒 200 个请求,下游就崩了。有了队列,进来 200 个请求只是往队列里一放堆积着,下游按自己能承受的速度慢慢消费,尖峰被拉成了一条平缓的曲线。这就是削峰填谷。
第三是异步。用户不需要等短信发出去、索引更新完才看到「提交成功」。接口返回速度快了,体验自然就上来了。
顺带还有一个容易被忽略的第四点:削峰的前提是消息不能丢。队列要是本身不可靠,削峰就变成了丢数据,这比同步调用慢一点严重得多。所以选型的核心不是「哪个最快」,而是「哪个能在你的业务约束下不丢消息、不乱序、还不至于运维到崩溃」。
还有一个概念要先掰清楚:投递语义。这决定了消息在各种异常情况下会怎样,这是三种方案差异最大的地方,也是最该先确定的。
至多一次(At Most Once):消息发出就不管了,消费者收到就处理,不成功也不重试。快,但可能丢消息。只适合日志采集、埋点上报这种丢了也无所谓的情况。
至少一次(At Least Once):消息确认后才从队列移除,消费者处理失败会重投。这是最常用的模式,代价是可能重复投递所以你的消费逻辑必须做成幂等的。转账、发券这类场景几乎都必须接受这个前提。
恰好一次(Exactly Once):不丢不重。听起来最美,但实现代价很大,跨系统的事务基本做不到真正的恰好一次,通常只是通过幂等 + 去重表把效果近似出来。Kafka 的事务机制比较接近这个语义,但也是限定在它自己的生态内。
Kafka 的设计思路和传统队列不太一样,它本质上是一个分布式可持久化的提交日志。消息不是「被某个消费者取走就没了」,而是追加到日志文件里,消费者维护自己的读取位置(offset)往后读。
这个设计带来了几个鲜明特点。
吞吐极高。顺序写盘 + 零拷贝 + 批量处理,让单机能跑到每秒几十万甚至上百万条消息。原因是它不需要复杂路由,每个分区内部顺序处理就行,并行度靠分区数堆出来。
消费者组(Consumer Group)机制。同一个组里的多个消费者分摊分区,一个分区同一时刻只归一个消费者。新消费者加入会自动再均衡,某个消费者挂了,它负责的分区会转给别人。这个特性让它天然适合做日志收集、埋点上报、流式计算多台采集器往同一个 topic 写,多个处理节点并行消费同一份数据。
消息可重复消费。因为消息在日志里存着,消费者可以重置 offset 重新读一遍。这是它的杀手锏功能:消费出错了不用原样重投,重新消费就行,而且回放历史数据做数据修复、重建下游索引也是常见用法。
代价也很明显:它不擅长延迟消息和灵活路由。Kafka 没有原生好用的「延迟队列」概念,要实现十几分钟后再触发,得靠自己造时间轮或者二级延迟队列的方案,灵活路由(比如按内容分发到不同队列)也不如 RabbitMQ 自然。而且单条消息延迟消费这个能力,RabbitMQ 那边是开箱即用的,Kafka 这块要费点功夫。
配置上也有坑:partition 数量决定了并行上限,建少了白白浪费机器性能;offset 提交策略如果设成自动提交,consumer 崩了可能丢消息,如果设成手动提交又容易重复消费;消费滞后(consumer lag)是判断 Kafka 健康度最关键的指标,lag 一路涨说明消费端跟不上了,得扩容消费者或者优化处理逻辑。
用 Kafka 之前建议先想清楚一件事:你的业务真的需要回放能力吗?如果只是为了异步发个短信,那 Kafka 那套分区、offset、消费组的复杂度就纯属自找麻烦。

RabbitMQ 是老牌 AMQP 协议的消息队列,杀手锏是灵活的路由。它支持交换机(Exchange)配合绑定键(Routing Key),可以把一条消息精确投递给一个队列、多个队列,或者干脆不匹配就丢掉。业务上常见的「订单支付成功」要同时通知「发货服务」「积分服务」「短信服务」三个下游,用 RabbitMQ 的 fanout 或者 topic 交换机就是几行配置的事,Kafka 得自己造 topic 或者外部转发层。
另一个非常实用的能力是延迟队列与死信队列。
死信队列(DLX)几乎是必备功能:消息消费失败、或者被拒绝、或者过期了,自动转移到一个专门的死信队列里,你再去人工排查。这解决了「消息丢了都不知道丢在哪」的痛点,我个人用下来觉得这是 RabbitMQ 最有价值的功能之一。
延迟消息则是秒杀、订单超时关闭、验证码过期这类场景的刚需。RabbitMQ 可以通过消息 TTL + 死信交换机组合实现延迟消费,Kafka 要绕点弯子。
RabbitMQ 的队列级 QoS 限流也很顺手:可以设置消费者每次 prefetch 多少条、消费者数上限,这在处理异构下游时特别有用慢的下游少拿点,快的不受影响。
缺点在吞吐和资源占用上。RabbitMQ 是消息级确认和路由的架构,每条消息都要走路由、都要维护投递状态,吞吐通常在每秒几千到两三万条这个量级,比 Kafka 差一个数量级。内存占用也更高,大并发场景下需要更多的节点来扛。
另外 RabbitMQ 有个经典的坑:队列堆积会撑爆内存。它是把消息放在内存里的(持久化消息也需要队列本身设置),一旦某个消费者挂了、消息大量堆积,broker 的内存会一路上涨,最后触发流控甚至 OOM。所以用 RabbitMQ 一定要配好队列长度上限和内存告警,超过阈值就赶紧扩消费者或者做降级。
还有个很多人不知道的:RabbitMQ 3.8 之后阉割了 Mirrored Queue,改成用 Quorum Queue 实现复制。老教程里讲的镜像队列配置在新版本已经用不了了,照着旧文章抄配置会直接报错。这大概是新手最容易踩的一个版本坑。
Redis Stream 是 Redis 5.0 之后加的数据结构,本质是持久化的日志式列表,带消费组机制,所以也能当消息队列用。它的定位很清楚:如果你已经有 Redis 了,又不想为了异步任务再多维护一个中间件,那 Stream 是最省事的选择。
它的优势主要在运维成本低。不用多开一台机器、不用多装一个中间件、监控告警看 Redis 那套就行,消息和业务数据还能放在同一个实例里,用 pipeline 一次性读写。
Stream 也支持消费组,多个消费者分摊消息,有 pending 列表可以查看谁拿了没确认,有自动确认和认领(XAUTOCLAIM)机制某个消费者崩了,消息不会永远卡在 pending 里,其他消费者可以把它重新认领走。这一点的完善程度比很多人在网上看到的旧介绍要高。
还能用 XREADGROUP 配合 BLOCK 阻塞读取,实现类似「没有消息就等着」的推送模式,不像 polling 那样空转浪费 CPU。
但它的短板同样明确:它是基于 List 的结构,消息被确认后是从流里删除的,不能像 Kafka 那样回放;没有原生的延迟队列(要么用 zset 自己模拟,要么靠定时任务扫描);单实例内存上限是硬约束,堆积量一大就危险;而且 Redis 的持久化是 RDB 或 AOF 异步的,宕机时理论上存在丢最后几秒消息的可能,对不能丢的业务要慎重。
所以我的判断是:业务量不大、消息可靠性要求中等、团队不想多维护组件的场景,Redis Stream 是性价比最高的选择。每天几十万条消息堆积、或者要求一条都不能丢,就别拿 Stream 硬扛了。
把三者摊开对比一下:
Kafka吞吐最高(十万级/秒以上),消费组和分区并行能力强,支持消息回放和历史数据重读,但延迟队列和灵活路由弱,学习和运维成本最高。适合日志收集、埋点、流式计算、大规模数据管道。
RabbitMQ路由最灵活,死信队列和延迟队列开箱即用,QoS 限流好用,但吞吐低一个量级、内存占用高、高堆积容易撑爆。适合业务消息、需要精准路由、延迟触发、失败重试严格控制的场景。
Redis Stream部署最轻、集成最快、消费组机制基本够用,但可靠性上限低、不能回放、堆积量受限。适合中小规模、已有 Redis、消息量不大的异步任务。
具体怎么选,我一般按这三条判断:
第一条,看消息量级和堆积特征。每天几万条以内、峰值不大,RabbitMQ 绰绰有余;每天上亿条或者持续高吞吐,Kafka 是唯一选项;中间量级且团队想省事,Redis Stream 试试水。
第二条,看业务对「延迟」和「路由」有多敏感。订单超时关闭、验证码过期、延迟通知这些是 RabbitMQ 的主场。而单纯为了解耦和削峰,三个都能干。
第三条,看你需不需要「回放」。这是个隐藏但很关键的问题:如果你的数据处理逻辑可能会改、会需要重新跑一遍历史数据(比如修数据、重建索引、跑一次回溯统计),Kafka 的日志模型能救你很多时间。RabbitMQ 和 Redis Stream 都不擅长这个。
另外还有两个横向因素不能忽略:团队的技术栈和运维能力。引入一个新中间件意味着多一套监控、多一套告警、多一套升级流程,如果团队只有一两个人,组件数量本身就是成本。还有云厂商托管服务这个选项,云上的 Kafka、RabbitMQ 免运维但成本高一些,如果你的量不大但又不想自己折腾,托管版反而比自建省心。
不管选哪个,这几件事都得做,做不好方案再对也会出事。
消费逻辑必须幂等。这是至少一次语义的必然要求。做法无非几种:用业务唯一键做去重表、用数据库唯一索引挡重复、用 Redis 的 SETNX 做前置锁、或者把状态机设计成可以重复执行同样的转换。我一般优先用数据库唯一索引,最省心也最可靠。
要有死信和人工兜底。RabbitMQ 有原生 DLX,Kafka 可以配失败 topic 自己转发,Redis Stream 可以靠监控 pending 列表捞出来。关键是死信队列一定要有人定期看,不然就变成了一个只进不出的垃圾堆,最后磁盘满了都不知道。
监控这几项指标。队列积压量(最关键的健康指标)、消费延迟、消费失败率、broker 内存和磁盘使用率、连接数。积压持续上涨就要么扩消费者,要么限流上游,要么把不重要的消费降级。对 Kafka 来说重点看 consumer lag,对 RabbitMQ 来说重点看队列长度和内存。
限流和降级别忘了。下游挂了的时候,上游是继续往队列里灌还是直接拒绝?灌进去的话队列会一直涨直到撑爆,正确做法是设置队列长度上限,超了触发限流或者降级返回。这部分设计在上线前就要想好,出事的时候没时间临时改。
别忘了版本和配置陷阱。RabbitMQ 的镜像队列在 3.8 后已废弃,改用 Quorum Queue;Kafka 3.x 之后 ZooKeeper 模式被废弃,KRaft 才是新常态;Redis Stream 的消费组在 Redis 7 之后有了一些行为变化。这些地方拿旧教程抄配置一定出事,装之前先看对应版本的官方文档。
总结一下:Kafka 是为数据流设计的日志型队列,RabbitMQ 是为业务消息设计的传统中间件,Redis Stream 是给轻量场景的顺手上选。别因为哪个名字响就上哪个,也别因为「消息队列」三个字就非得单独部署一套重型设施。
如果拿不准,我的建议是:先从最轻的方案起步。业务量小的时候用 Redis Stream 或者干脆用数据库表加定时任务顶一顶,等到量真的上来了、痛点真的显现了,再迁到 RabbitMQ 或者 Kafka。很多团队一上来就上 Kafka,结果三天后一半人在跟分区和 offset 打架,异步任务反而成了新的复杂度来源。
不管最后选哪个,有三件事签方案之前一定要写进文档:消息可靠性等级(丢一条能不能接受)、消费幂等策略、积压的应急处理流程。这三件事定了,剩下的就是选工具。
想看队列跑起来之后的数据长什么样,可以用 Kafka Assistant 这类可视化管理工具连上去看 topic、分区、消费组和 lag,排查问题时比命令行清晰得多。
